레이블이 math인 게시물을 표시합니다. 모든 게시물 표시
통계에 있어서 기본적인 것들(3)

통계에 있어서 기본적인 것들(3)


저번에 다중비교와 자유도 그리고 분포까지 알아보았는데요. 역시 별로 어려울게 없습니다. 고수준의 이해를 필요로 하지도 않고요. 이제 여기에 포스트된 것까지만 하면 통계의 기본은 끝납니다. 그 다음부터는 적용의 문제가 기다리고있죠. 언제 어떤 분포를 사용하고 언제 어떤 방법으로 통계치를 분석할 수 있을 지 등등이요. 하지만 이 통계에 기본에 기초하고 있는것이라 사용하는데에는 큰 문제 없을거에요. 그럼 오늘은 중심극한정리와 모수적방법 그리고 자료의 정규성검정까지 알아볼게요.

중심극한정리

중심극한정리는 "많은 수의 표본이 있으면 그 표본의 합이나 평균이 정규분포를 따른다." 라는 말인데요. 이렇게 적어놓으면 어렵죠. 정육면체의 주사위를 열번정도 굴리면 어떤 숫자는 적게나오고 어떤 숫자는 더 많이나오고 어떤숫자는 아예 안나올 수도 있죠? 그런데 수백번,수천번 굴렸다고 해보죠. 그럼 각각의 나온 횟수가 1/6에 근사하게 나올겁니다. 그렇다면 주사의를 두개를 수천번 굴려서 그 합을 나타내볼까요? 그렇다면 아마 기대값에 가까운 숫자는 높게 그와 떨어진숫자들은 점점 적게 나올겁니다. 마치 정규분포의 모양처럼요.

이렇게 표본을 충분히 많이 확보할 수 있으면 그 표본변수의 합이나 평균같은게 정규분포를 따른다는 말이에요. 그 원래 모집단의 분포에 따라서 그 표본의 개수는 차이가 있겠죠. 분산이 큰 표본은 더 많은 수의 표본을 필요로 하고 이런것들이요. 그러나 모집단의 분포를 몰라도 표본이 충분히 크다면 구지 신경안써도 되는 부분입니다.

이렇게 중심극한정리를 이용하면 집단간에 평균비교로 집단차이를 비교할수 있고요. 또 정규분포라는 가정하에 하는 실험들도 많이있습니다.


모수적방법 VS 비모수적방법

추출된 표본의 평균이나 분산 표준편차 같은걸 통계량이라고 하고요. 원래 모집단의 평균 분산 표준편차를 모수라고 합니다.

그런데 위에서 봤듯이 겁나 많은통계의 평균혹은 분산은 정규성을 띈다고 볼 수 있으므로 그것을 이용한 것이 모수적방법입니다. 이때 표본의 크기가 작다고 생각될때 정규성 검정을 할 수 있죠. 정규성 검정은 밑에서 다시설명하겠습니다. 

그런데 정규성검정에서 떨어지거나 표본이 얼마없는 소규모의 실험은 순위합검정 같은 비모수적 방법을 사용합니다. 이것도 대부분 모수적방법과 비교해봤을 때 만약 표본이 정규분포를 따를때에도 검정력이 크게 떨어지지는 않는다합니다. 그리고 표본의 분포가 멀리떨어진 경우에는 어쩔 수 없이 비모수적 방법을 사용해야겠지요.

그러나 모수적방법의 선호 이유는 검정력이 다소높고 비교 군 사이에 크기차이가 있는 경우엔 차이정도도 함께 제시할 수 있기때문입니다.


정규성검정

위에서 말했듯이 통계적방법들은 보통 정규분포를 따른다고 가정합니다. 그러나 모든 표본이 정규분포를 따르는 것은 아니기 때문에 이 정규성 검정을 거쳐야 될 때도 있죠. 표본수가 10개보다는 많은데 그렇다고 충분할 정도로 많지 않으므로 정규성검정을 거치는 거에요. 검정방법은 Kolmogorov-Smirnov Test와 Shapiro-Wilk Test가있습니다.
통계에 있어서 기본적인 것들(2)

통계에 있어서 기본적인 것들(2)


지난번 독립변수, 종속변수, 자료분류, 가설검증방법, 유의수준에 이어서 이번에도 통계에 있어서 기본적인 것들 다중비교, 자유도 그리고 분포를 알아볼게요.

다중비교

A = B = C 라는 것을 검증할 때 흔히 하는 실수가 있습니다. 유의수준을 5%라고 하면 A = B를 검증할때도 5%이하의 오류율을 보이고 B=C를 검정할때도 5%, C=A도 5%이렇게 된다면 전체 실험의 유의수준은 5%보다 훨씬 올라가겠죠? 예를 들면, 유의수준5%는 원하는 가설을 채택했을때 그 채택한 가설이 참이될 확률을 95%이상이 되겠금하는 것이죠. 그런데 한번의 가설을 채택하는데 유의수준을 각각 책정한다면 최종적으로는 .95 x .95 x .95 = .857 밖에 맞을확률이 없는 것이네요. 그러므로 이런 다중비교를 할때는 전체유의 수준이 5%를 넘지 않도록 해야하죠. 이렇게 동시에 비교를 하기위해서 Bonferroni, Turkey, Ducan, Scheff 방법등이 있어요.


자유도

자유도는 실질적으로 독립인 값들의 개수이죠. 그렇다면 m개값의 평균을 낼때 그 자료의 자유도는 m-1이죠? m-1개의 값이 정해지면 나머지 1개는 저절로 정해지니깐요. 그리고 m x n의 교차표는 (n-1) x (m-1)의 자유도를 가집니다.


분포

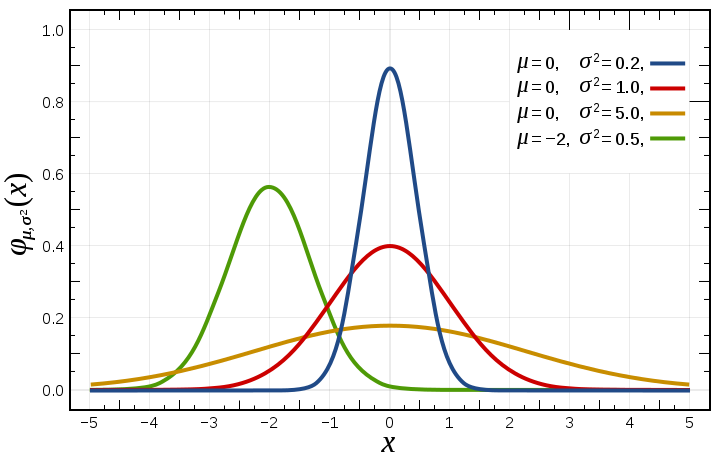
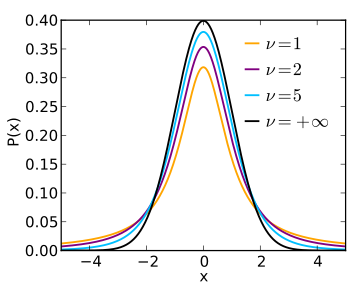
동일한 실험을 여러번 하고 그 실험의 결과값을 그래프로 그려보면 특정한 모양을 띕니다. 평균값에 몰려있고 평균과 멀어질수록 적은 결과를 가지고있는 모양이 대부분이죠?

파일:Normal Distribution PDF.svg
정규분포

파일:Student t pdf.svg
T-분포

파일:Chi-square distributionPDF.png
카이제곱 분포
푸아송 분포
                               
정말 여러 모양의 분포들이 있죠? 이런 분포들은 쓰는 상황이 각자 다릅니다. 그래서 이렇게 많이 만들어져 있겠죠? 사용하는 이유는 이러한 분포모양을 예측함으로써 많은 실험을 하지 않고도 어떤 값이 나올 확률을 알 수 있습니다. 그래프의 아래의 면적을 모두 합치면 1이됩니다. 그러므로 어떤값 이상이나 어떤값이하가 나올 확률을 면적으로 구하면 되는거죠. 그러한 면적들 값도 표로 정리되어 있어서 가져다 쓰는 방법만 알면 복잡한 적분없이도 확률예측을 할 수 있게됬어요. 고맙네요.


통계에 있어서 기본적인 것들(1)

통계에 있어서 기본적인 것들(1)

왜 통계가 어려울까?

통계라는 것은 어렸을때 중학교,고등학교 때부터 확률의 연장선으로 항상 따라다니던 부분이죠. 그 만큼 중요성과 활용성은 학창시절 배우는 것중의 탑클래스라 생각됩니다. 뭐든 중요하지만요. 그런데도 통계, 확률만 나오면 어렵게만 생각되는 이유는 뭘까요? 매번 큰 그림없이 간헐적으로 기법들만 배우다보니 그런것이 아닌가 생각됩니다. 이런 생각도중에 책한권을 소개받았습니다. "닥터 배의 술술 보건의학통계" 라는 책인데요. 이 책은 통계의 기본을 가지고 의학에 필요한 실험, 분석등을 예시로 들면서 설명하는 책입니다. 여기서 나오는 의학적인 내용은 상당히 기본적이므로 통계를 배우는데에는 지장없을 정도입니다. 뿐만아니라 그림 예시가 많으므로 그 만큼 독자들의 이해정도는 더 높아집니다.

이 책에 있어서 가장 중요한 부분은 첫 번째에 나와있습니다. 통계방법을 설계하고 기법을 선택할 수 있는데 있어서 기본인 부분입니다.


독립변수 vs 종속변수

우선 독립변수와 종속변수의 관계부터 이해하죠. 독립변수는 어떤 상황에 있어서 독립인 변수죠. 전의 실험이나 확률에 대해서 영향 받지 않는 변수입니다. 그 반대가 종속변수이므로 종속변수는 그 전의 변수에 의해서 영향을 수이죠.  


자료 분류

자료들은 분류될수있겠죠? 이 분류하는 방법에 따라서 discrete과 continuous으로 나눌 수 있습니다. discrete은 수치화 하기 어려운 것아니면 수치를 구간으로 나누어 순서로 활용할 때 더 이용하기 쉬운 데이터들 입니다. 예를 들면 털이 많다, 적다, 중간이다. 이런 식으로 구분해놓은 데이터는 discrete이고 털이 1센치 제곱만큼의 구역에 몇가닥이 있다. 이런식으로 수량화해놓은 것은 continuous입니다. 그런데 주위할 것은 숫자가 나와서 continuous 데이터로 착각하면 안됩니다. 털이 많고 적음을 5개의 구간으로 나워서 1급~5급까지 나눠 놨다면 이것은 discrete 데이터입니다.


가설검증방법

귀무가설 : 내가 검증하려는 것과 반대
대립가설 : 내가 검증하려는 것

이렇게 놓고 귀무가설을 입증하는 데 귀무가설이 맞을 확률이 0.05% 미만이면 대립가설을 채택하고 귀무가설을 기각합니다. 그러므로 우위성을 입증하냐, 동등성을 입증하냐에 따라서 귀무가설, 대립가설 설정이 다릅니다.

우위성입증인 "A약이 B약보다 효과가 있다"를 입증할 때는 "A약과 B약은 효과에 차이가 없다"가 귀무가설입니다. 반대로 동등성입증인 "A약과 B약은 효과에 차이가 없다"를 입증할 때는 "A약과 B약은 효과에 차이가 있다"가 귀무가설입니다.


5% 유의수준

가설검증에서 귀무가설이 실제로 참일 때 귀무가설에 대한 판단의 오류수준(잘못 기각할 확률)을 말하며, 제1종 오류의 위험성을 부담할 최대 확률을 가설의 유의수준이라고 한다.
[네이버 지식백과] 유의수준 [level of significance] (교육평가용어사전, 2004.5.31, 학지사)
귀무가설을 기각할 때 판단하는 오류수준입니다. 귀무가설이 나올확률이 5%이상이면 귀무가설을 채택하고 대립가설을 기각함으로써 알파오류를 경계하는 것입니다. 가설을 검증하는데 있어서 오류를 2가지로 나눌 수 있겠죠?

하나는 귀무가설을 기각했는데 실제로는 귀무가설이 참인 경우입니다.
두번째는 귀무가설을 채택했는데 귀무가설이 거짓인 경우입니다.

그런데 두번째 경우에는 내가 검증하려는 것과 반대의 결과가 나옴으로써 이 실험은 발표되지 않습니다. 그러므로 위험성이 첫번째 경우보다 적다고 할 수 있겠죠? 첫 번째는 대립가설이 채택되서 발표했는데 사실상 그렇지 않은 경우가 많으므로 위험성이 크다고 할 수 있죠. 그래서 이 오류를 알파오류, 두번째 오류를 베타오류라고 하는겁니다.

이 알파오류가 나올 확률을 5%미만으로 하자고 학계에서 권고를 합니다. 그리고 귀무가설이 기각되었고 실제로도 귀무가설이 거짓일 경우에 (1-베타오류수준)으로  효과를 증명할 수 있습니다. 이것을 검정력이라고 하며 이 검정력을 최대로 하기위해서 많은 실험에서 통계기법을 각자 다르게 사용하는 것입니다.


이 외에 다중비교, 자유도, 분포, 검정통계량, 중심극한정리, 모수적방법과 비모수적방법, 정규성검정 방법 등 여러가지의 기본은 다음에 계속할게요.